
Originalmente publicado por vincanger - DEV Community
Claude Code para Desenvolvimento Full-Stack: As 3 Coisas Que Você Realmente Precisa
Como Posso Usar Claude Code Efetivamente?
Há muito hype em torno de vibe coding com Claude Code.
A boa notícia é que é justificado. Claude Code pode cuidar de algumas tarefas de codificação surpreendentemente complexas.
A má notícia é que é exagerado, com afirmações de aplicativos incríveis sendo vibe coded em poucas horas, ou fluxos de trabalho complexos que usam 10 sub-agentes paralelos em loop para substituir o trabalho de 5 engenheiros de software.
Se você ainda não é um usuário avançado de Claude Code, todo esse hype pode deixá-lo questionando como usá-lo efetivamente. Estou perdendo ganhos de produtividade por não adotar esse novo fluxo de trabalho insano? Devo usar sub-agentes, comandos, skills ou servidores MCP para meu caso de uso? Se sim, como?
Eu estava me fazendo essas mesmas perguntas, então fiz algumas boas semanas de pesquisa e testes, e cheguei à seguinte conclusão:
Com apenas algumas ferramentas bem escolhidas e os recursos básicos do Claude Code, você tem o suficiente para fazer vibe code de ótimos aplicativos full-stack.
Você Não Precisa de Todos os Seus Recursos
Estranho ver todos esses fluxos de trabalho e ferramentas LLM complexas. Enquanto isso, eu executo uma conversa contínua do Claude por projeto… Nunca usei um sub-agente. Nunca usei MCP…
E tenho resultados selvagemente bons ¯_(ツ)_/¯
— Chris McCord, criador do framework Phoenix
Embora as capacidades do Claude Code sejam impressionantes, você rapidamente percebe que há muito sobreposição de recursos e coisas que você simplesmente não terá que tocar frequentemente se acertar algumas coisas desde o início. Vou explicar o que são essas coisas e depois entrar em mais detalhes sobre cada tópico neste artigo.
1. Forneça-lhe visibilidade completa de debugging full-stack
- Isso permite que Claude realmente veja e responda ao que está codificando, em vez de termos que copiar e colar erros ou descrever problemas.
2. Dê ao Claude Code acesso a documentação atualizada e amigável para LLM
- Isso é crucial ao trabalhar com LLMs que podem ter conhecimento desatualizado, alucinar soluções ou ser confundidos por documentação “barulhenta” que não é otimizada para LLMs.
3. Use a pilha de tecnologia ou framework correto
- Esta é provavelmente a mais negligenciada dessas três abordagens. Ao escolher o framework certo, você dá ao AI padrões claros a seguir e remove muita complexidade desde o início.
Com essa base, você será capaz de construir e implantar aplicativos fullstack facilmente usando principalmente os fluxos de trabalho padrão do Claude Code, e apenas alguns comandos/skills personalizados (também empacotar essas ideias em um simples plugin Claude Code que você pode instalar e usar, mas falarei mais sobre isso depois).
Essa abordagem funciona porque fornece guardrails e os padrões certos para o agente seguir, para que você possa gastar mais tempo na implementação da lógica de negócios e menos tempo trabalhando especificações e detalhes técnicos.
Essencialmente, você consegue trabalhar com o agente no o quê você quer, em vez de ter que explicar como você quer, trazendo aquele sentimento mágico de codificação assistida por IA para aplicativos complexos e full-stack.
Vamos mergulhar.
Dando ao Claude Code Visão Full-Stack
Estabelecendo um Loop de Feedback Apertado
Nosso fluxo de trabalho típico de codificação assistida por IA tende a parecer assim: fazemos um prompt, depois esperamos, depois analisamos o código gerado (talvez), depois verificamos as coisas no navegador. Se temos alguns erros ou alguns designs de frontend com aparência ruim, copiamos e colamos e tentamos (melhor) explicar o que queremos.

O que é pior é que podemos ter que fazer isso algumas vezes antes de ficarmos satisfeitos ou conseguirmos fazer as coisas funcionarem novamente.
Ao nos manter sempre no loop, estamos desacelerando muito. Devemos, às vezes, apenas sair do caminho e deixar o agente melhorar o código com cada iteração até terminar, antes de verificar o resultado.
Mas para fazer isso, precisamos dar ao Claude Code um “conjunto de olhos”. Felizmente, isso é possível com os recursos e ferramentas certos, permitindo que ele veja os resultados do código que escreveu e o modifique rapidamente de forma autônoma se encontrar um erro em qualquer lugar da pilha.
Vamos ver como.
Executando o Dev Server como uma Tarefa de Fundo
Claude Code introduziu seu recurso de tarefas de fundo que permite executar tarefas de longa duração, como servidores de desenvolvimento de aplicativos (por exemplo, npm run dev), sem bloquear o progresso do Claude em outro trabalho. A parte legal é que Claude pode continuar lendo e respondendo à saída dessa tarefa enquanto você trabalha.

Para executar comandos em segundo plano, você pode:
- Solicitar ao Claude Code que execute um comando em segundo plano, por exemplo,
"execute o servidor dev do meu aplicativo em segundo plano" - Pressionar Ctrl+B para mover uma invocação regular da ferramenta Bash para o segundo plano, por exemplo,
"execute o servidor dev"+Ctrl+bconforme ele inicia
Mesmo que Claude possa ler a saída de suas tarefas de fundo, há momentos em que você pode querer verificá-las você mesmo, e ainda pode fazer isso. Basta usar a seta para baixo para destacar a mensagem de tarefa de fundo e pressionar enter.
Isso é ótimo porque agora Claude pode reagir a problemas que ocorrem ao construir e servir seu código. Infelizmente, ainda não pode reagir a erros que ocorrem enquanto seu aplicativo está sendo executado no navegador.
Mas há uma maneira legal de resolver isso.
Ferramentas de Automação de Navegador
A peça que falta até agora é dar ao Claude a capacidade de realmente ver o resultado do código que escreveu, mais tipicamente como é a aparência da UI.
Problemas que aparecem apenas depois que o aplicativo está sendo executado no navegador, como problemas de design e erros em tempo de execução, ainda não são visíveis para o agente. Então isso tende a ser onde o humano entra para relatar de volta: “o botão está desalinhado”, “há um erro 404 ao tentar fazer login”, “o console diz algo sobre undefined”.
Mas felizmente, podemos equipar Claude Code com ferramentas de automação de navegador para resolver isso. Essas ferramentas permitem controle programático do navegador, como carregar páginas, clicar em botões, inspecionar elementos, ler logs do console e até tirar capturas de tela.

Isso fecha o loop para a pilha inteira e dá ao Claude a autonomia para completar tarefas de recursos maiores inteiramente por conta própria.
Chrome DevTools MCP server é uma das melhores opções disponíveis atualmente, embora haja muitas alternativas. É fácil de instalar e se especializa em debugging de navegador e insights de desempenho.
Para instalá-lo, execute o seguinte comando no terminal para adicioná-lo ao seu projeto atual:
claude mcp add chrome-devtools --scope project npx chrome-devtools-mcp@latest
Em seguida, inicie uma nova sessão do Claude e dê a ele um prompt como:
Verifique no navegador que sua alteração funciona conforme esperado.
```Você deve ver uma instância separada do Chrome se abrir sendo controlada pelo Claude. Vá em frente e dê a ele mais tarefas como:
- autenticar um usuário de teste
- verificar a pontuação de desempenho do Lighthouse de um site (por exemplo, quão rápido ele carrega)
- fornecer feedback sobre como melhorar o design do seu aplicativo
### Juntando Tudo
https://youtu.be/eS1Uio_rrP8
Agora, quando você estiver implementando recursos full-stack no seu aplicativo, peça ao Claude para verificar se o recurso funciona corretamente verificando os logs no servidor de desenvolvimento, bem como no navegador com o Chrome DevTools MCP.
Alternativamente, se você quiser que Claude *sempre* verifique automaticamente as alterações no navegador com o DevTools MCP sem ter que pedir explicitamente, você pode [adicionar uma regra à memória do Claude no seu arquivo `CLAUDE.md`](https://code.claude.com/docs/en/memory#set-up-project-memory).
---
## Dê ao Agente Acesso à Documentação Correta
### O Problema de Versionamento
Você provavelmente já experimentou isso: você está codificando usando a API de uma biblioteca, e a IA escreve com confiança código que teria funcionado perfeitamente… duas versões atrás. Ou cria alguma solução maluca e super engenheirada para um problema conhecido que tem uma solução simples em sua documentação.
Isso ocorre porque os dados de treinamento do modelo têm uma data de corte. LLMs e ferramentas como Claude não têm como saber sobre padrões de código atualizados, a menos que você lhes dê acesso à documentação atual.
Mas, como [Andrej Karpathy observou](https://x.com/karpathy/status/1899876370492383450), a maioria da documentação contém conteúdo que não é relevante para LLMs:
> *99% das bibliotecas ainda têm documentação que basicamente renderiza para algumas páginas HTML estáticas bonitas assumindo que um humano vai clicar nelas. Em 2025 a documentação deveria ser um arquivo de texto your_project.md que se destina a entrar na janela de contexto de um LLM.*
Há [pesquisa que respalda sua afirmação,](https://research.trychroma.com/context-rot) mostrando que o desempenho do LLM se degrada quando conteúdo irrelevante, como sintaxe HTML ou instruções verbosas para humanos, é adicionado ao contexto, pois distrai da tarefa e reduz a precisão.
**Em outras palavras, cada token desnecessário na sua janela de contexto torna a IA ligeiramente pior em seu trabalho.**
Então precisamos dar ao Claude Code o *tipo certo* de documentação.
### A Solução: Acesso a Documentação Curada
A solução é simples: dê ao agente a capacidade de buscar e ler a documentação relevante e otimizada para LLM das ferramentas que você está usando.
Aqui estão as duas principais maneiras pelas quais os desenvolvedores estão realizando isso:
- **Servidores MCP** — Um padrão para sistemas externos servirem dados a agentes de IA. Ferramentas de desenvolvimento populares, como [Vercel](https://vercel.com/docs/mcp/vercel-mcp), disponibilizam essas com ferramentas de busca de documentação.
- **llms.txt e mapas de documentação** — Um padrão para publicar documentação amigável a LLM em uma URL bem conhecida, por exemplo, [https://wasp.sh/llms.txt](https://wasp.sh/llms.txt). O agente busca documentação estruturada otimizada para janelas de contexto de LLM.
### Servidores MCP para Busca de Documentação
O [Model Context Protocol (MCP)](https://modelcontextprotocol.io/) é um padrão aberto para conectar aplicações de IA (ou seja, agentes, LLMs) a sistemas externos. Claude Code pode se comunicar com um servidor MCP para acessar ferramentas e informações especializadas.
Já existem muitos servidores MCP para ferramentas populares, como Supabase, Jira, Canva, Notion e Vercel. Claude Code tem [uma seção de documentação listando esses e muitos mais](https://code.claude.com/docs/en/mcp#popular-mcp-servers), com instruções sobre como instalá-los se estiver interessado.
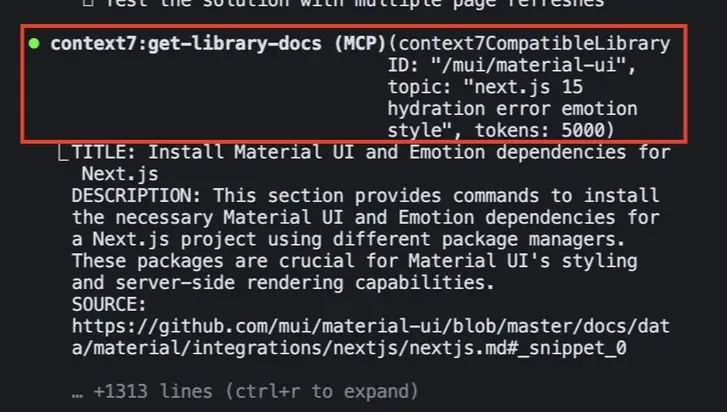
Servidores MCP de Ferramentas de Desenvolvedor como [Supabase](https://supabase.com/docs/guides/getting-started/mcp) e [Vercel](https://vercel.com/docs/ai-resources/vercel-mcp) têm ferramentas que buscarão documentação para o agente com base em uma consulta. Há alguns prós e contras para essa abordagem, porém.
**Prós**
- podem fazer algum pré-processamento na documentação antes de enviá-la de volta
- podem verificar versão, filtrar e buscar trechos relevantes em várias documentações/guias
- retornar saídas estruturadas em vez de texto bruto
**Contras**
- o servidor MCP decide o que é relevante, ignorando informações potencialmente úteis
- todas as suas ferramentas (não apenas ferramentas de busca de documentação) são carregadas e rapidamente preenchem a janela de contexto do LLM, degradando o desempenho do agente
- mais sobrecarga para o agente: avaliar prompt → encontrar a ferramenta MCP correta → chamá-la → aguardar resposta do servidor MCP → avaliar resposta → tomar ação
Como LLMs não têm memória real, eles precisam carregar informações no contexto a cada nova sessão, como as ferramentas que podem usar. Um único servidor MCP pode adicionar cerca de 15-30 ferramentas ao contexto, e com vários servidores você pode facilmente consumir 10-20% ou mais da janela de contexto do seu LLM antes mesmo de começar a trabalhar.
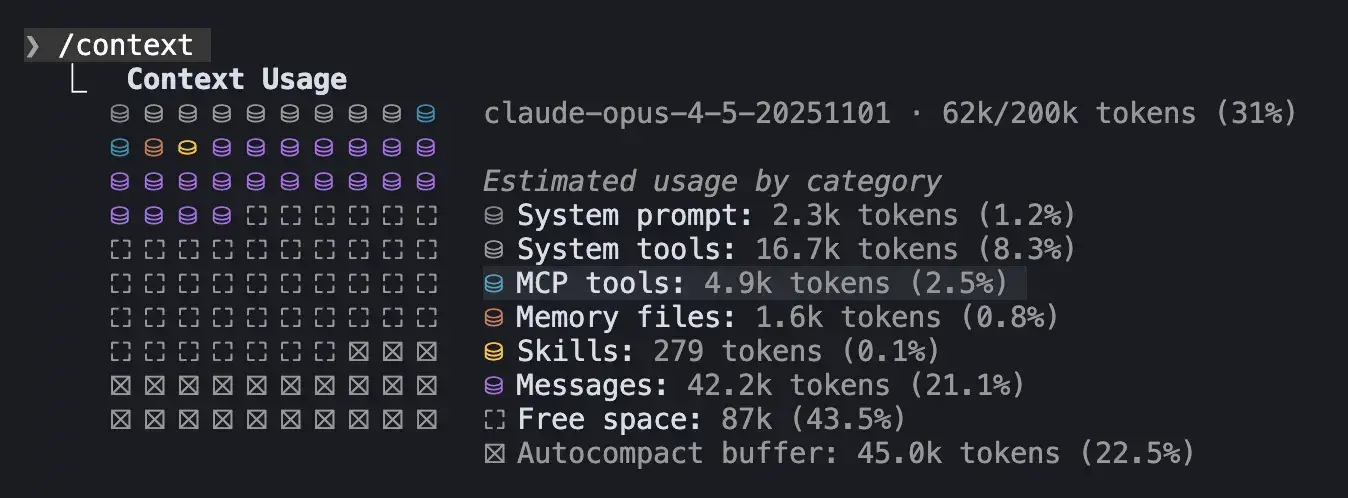
Se você quiser ver quanto da sua janela de contexto já está sendo usado, você pode executar o comando de barra `/context` em uma sessão ativa do Claude Code.
O exemplo acima mostra que 2,5% da janela de contexto é usado por apenas um servidor MCP.
E conforme a janela de contexto de um LLM se enche, seu desempenho se degrada. Alguns desenvolvedores até sugerem iniciar uma nova sessão quando o contexto está 75% cheio para evitar isso, o que é possível com o comando `/clear` no Claude Code. Você também pode executar o comando `/compact` que cria um resumo do contexto da sua sessão atual e o passa para a próxima sessão.
Felizmente, se sua principal razão para usar um servidor MCP é apenas para busca de documentação, então existe um padrão aberto alternativo que pode ser mais adequado.
### URLs de Documentação Amigáveis a LLM — LLMs.txt
[LLMs.txt](https://llmstxt.org/) rapidamente se tornou o padrão para fornecer aos LLMs versões amigáveis ao contexto de sites em um caminho `/llms.txt`.
Experimente em algumas URLs de suas ferramentas de desenvolvedor favoritas, como:
- [stripe.com/llms.txt](https://stripe.com/llms.txt)
- [supabase.com/llms.txt](https://supabase.com/llms.txt)
- [wasp.sh/llms.txt](https://wasp.sh/llms.txt)
https://youtu.be/zBsc8nIiXGk
Embora os arquivos llms.txt possam variar muito no conteúdo que apresentam, eles sempre seguem o mesmo formato de um arquivo markdown simples com o título do site e alguns links. É isso! Isso permite que LLMs obtenham informações precisas sem toda a bagunça.
Aqui estão alguns dos prós e contras de usar llms.txt para busca de documentação:
**Prós**
- lista curada das informações mais relevantes para LLMs e agentes
- extremamente simples; funciona com qualquer agente que possa buscar URLs
- agentes decidem quais links seguir e podem ver texto fonte completo
- muito eficiente em janela de contexto
**Contras**
- documentação bruta / arquivos markdown podem transmitir mais informações do que o necessário
- o agente pode buscar links / arquivos incompatíveis
- o agente pode precisar de mais orientação / regras sobre como interagir corretamente com a documentação
Na minha opinião, acho que buscar documentação via uma URL `llms.txt` é a abordagem melhor, pois é mais eficiente em contexto. Por exemplo, um arquivo de documentação típico é ~100 tokens versus 5.000-10.000 tokens para apenas um servidor MCP.
**Essa é uma redução de 10x no uso de contexto.**
Claude Code também é ótimo em navegar mapas de documentação para buscar apenas as informações mais relevantes. Além disso, você tem o benefício adicional de que os arquivos `llms.txt` são mais fáceis para humanos consultarem também.
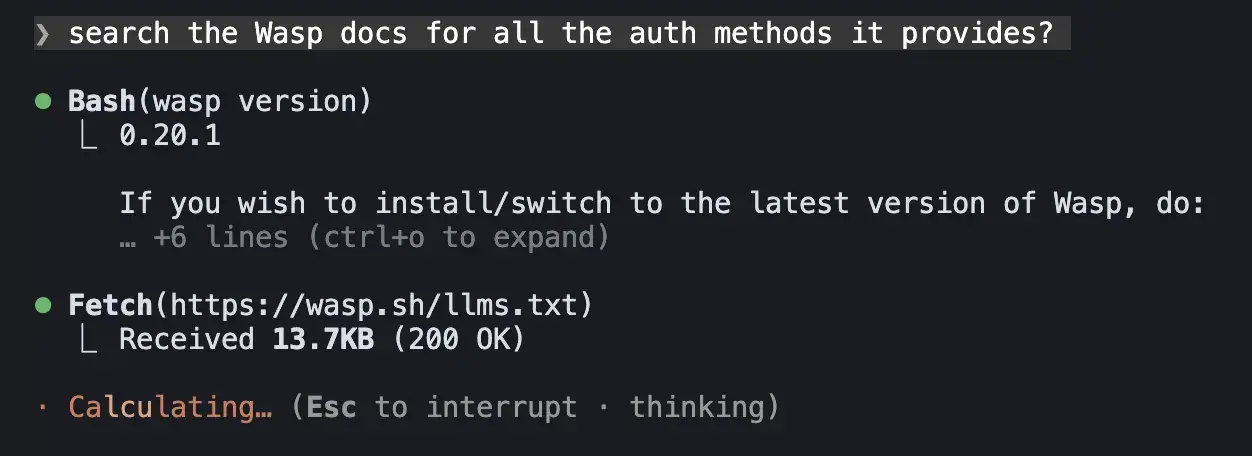
É também o método que Claude Code usa para sua [própria busca de documentação internamente](https://simonwillison.net/2025/Oct/24/claude-code-docs-map/). Então quando você faz uma pergunta sobre seus próprios recursos, ele primeiro busca seu [arquivo markdown de mapa de documentação URL](https://simonwillison.net/2025/Oct/24/claude-code-docs-map/) para encontrar os guias corretos.
Então agora que você sabe como dar ao Claude Code acesso à documentação atualizada, a próxima pergunta a responder é quais ferramentas você pode precisar fornecer documentação?E a resposta mais óbvia é a **pilha tecnológica ou framework** com o qual você está construindo seu aplicativo full-stack.
---
## Escolhendo a Pilha Tecnológica / Framework Certa
### Escolhas Populares
Esta é provavelmente a mais negligenciada dos 3 pilares.
Começar com uma pilha tecnológica que a IA possa raciocinar facilmente tornará o trabalho de construir o aplicativo que você deseja significativamente mais fácil. Existem muitas opções por aí, mas felizmente há muitas escolhas sólidas, como:
- [Wasp](https://wasp.sh) (React, NodeJS, Prisma)
- [NextJS](https://nextjs.org/docs) (React, NodeJS)
- [Laravel](https://laravel.com/docs) (PHP)
- [Ruby on Rails](https://rubyonrails.org/docs) (Rails)
Em 2026, você conseguirá ir muito longe com Claude Code e qualquer um dos frameworks listados acima. Mas embora esses frameworks ofereçam boas convenções e sejam responsáveis por unir as partes mais importantes da pilha, a maioria deles ainda requer algum tipo de integração adicional.
### Qual você deve escolher?
Para NextJS, que é mais focado no lado do cliente, você tem que escolher e conectar sua própria camada de banco de dados. Para Laravel e Rails, que unificam backend e banco de dados, você precisa decidir qual cliente usar e como ele se comunicará com seu backend.
É por isso que muitos desenvolvedores recorrem a pilhas/combos populares que incluem esses frameworks, como:
- NextJS + tRPC + Prisma + NextAuth (também conhecido como [T3 Stack](https://create.t3.gg/en/introduction))
- [Laravel + Inertia.js + React](https://inertiajs.com/docs/introduction)
- [Rails + Hotwire](https://hotwired.dev/)
Você também pode ter notado que o T3 Stack é o único a incluir uma biblioteca de autenticação, NextAuth. Isso ocorre porque os frameworks focados em backend, Laravel e Rails, já têm uma forma opinativa de adicionar autenticação ao seu aplicativo, mas NextJS não.
Wasp, por outro lado, é o único do grupo que unifica todas as partes da pilha — cliente ↔ backend ↔ banco de dados — enquanto também é opinativo sobre recursos.
**Tudo isso é ótimo, mas qual você deve escolher no final?**
### Quanto Mais Opinativo, Melhor
Bem, quanto mais opinativo o framework, melhor ele funciona com IA.
Se um framework é **opinativo**, significa que geralmente há um lugar óbvio para colocar código e um padrão comum a seguir. A IA não precisa adivinhar. Eles já tomaram decisões antecipadamente para que você (e seu agente) não tenha que fazer. Eles codificaram sabedoria arquitetônica em convenções, escolheram as bibliotecas a usar, a forma como a autenticação é conectada e como o aplicativo deve ser estruturado.
**Então, quando há menos decisões a tomar, menos boilerplate para escrever e menos ferramentas para unir, o processo de desenvolvimento se torna mais confiável.**
E conforme o aplicativo fica mais complexo, a IA não perde seu foco, porque o framework está lidando com muita complexidade subjacente. Você também pode entender e inspecionar o que está sendo gerado mais facilmente e evitar se colocar em um canto bagunçado.
Considere que **frameworks opinativos podem reduzir boilerplate em 60-80%**. A declaração de autenticação do Wasp, por exemplo, substitui 500+ linhas de código de autenticação típico por uma configuração de 10 a 15 linhas. Isso é 97% menos código que precisa ser gerado e auditado!
Desses frameworks, Wasp é definitivamente o mais opinativo, mas também é o mais novo do grupo. Depois disso, Laravel e Rails provavelmente estão empatados em segundo lugar, mas são construídos em PHP e Rails, respectivamente, e vêm com seus próprios ecossistemas distintos, então você provavelmente terá que emparelhá-los com um framework JavaScript frontend como React também. NextJS é o mais popular, mas o menos opinativo do grupo, então significa que há mais complexidade e escolhas iniciais que você e sua IA têm que lidar, mas isso oferece mais flexibilidade a longo prazo.
Então, no final, a escolha que você faz depende muito do que você está tentando alcançar, com o que você se sente confortável e de quanta flexibilidade você precisa.
Apenas lembre-se, quanto mais um framework lhe dá estrutura e padrões, mais fácil é para a IA gerar código que se encaixa corretamente — e menos tempo você gasta corrigindo saídas confusas ou inconsistentes.
### O Que Isso Significa para Claude Code
Ok. Então estabelecemos que trabalhar com um framework opinativo significa que ele gerencia muita complexidade para você.
Mas o que isso significa praticamente ao usar com Claude Code?
- **Subagentos para planejamento arquitetônico?** O framework já decidiu a arquitetura.
- **Planos elaborados para onde o código deve ficar?** As convenções dizem a você.
- **Vai e vem para concordar com padrões?** Os padrões já foram decididos.
- **Unir as peças do seu aplicativo?** Os frameworks gerenciam este código.
- **Contexto que explica a estrutura do seu aplicativo?** Está incorporado no framework.
De certa forma, o framework atua como uma grande especificação que você e Claude já entendem e concordam.
**Em vez de conversas multi-turno para descobrir COMO as coisas devem ser construídas, você apenas diz O QUE quer construir.**
Então, quando você diz a Claude "adicione um novo modelo para Comentários" ou "adicione um recurso de configurações de conta do usuário", Claude saberá exatamente o que isso significa e para onde tudo vai. E você também obtém o benefício adicional de que as implementações seguem as melhores práticas e são apoiadas pelas decisões de profissionais experientes por trás do framework, e não apenas alguma [IA implementando apressadamente um recurso com suposições erradas.](https://x.com/karpathy/status/2015883857489522876)
Isso não quer dizer que você não precisa mais fazer um bom planejamento, criar uma boa especificação ou Documento de Requisitos de Produto para seu agente seguir. Isso ainda pode ser uma etapa realmente importante ao fazer vibe coding (ou praticando "[desenvolvimento orientado por especificação](https://martinfowler.com/articles/exploring-gen-ai/sdd-3-tools.html)").
Mas significa que, com um framework full-stack opinativo, muito menos de suas fases de planejamento precisa ser dedicado a discutir detalhes de implementação arquitetônica e técnica.
---
## Esta Abordagem, Em um Plugin
Se você quer colocar à prova prática a abordagem teórica que discuti acima, sugiro que experimente o [plugin Wasp que criamos para Claude Code](https://github.com/wasp-lang/claude-plugins/tree/main/plugins/wasp).
Nós, os criadores do framework Wasp, mantemos o plugin, então o testamos em batalha com Wasp. Além disso, somos uma comunidade muito responsiva e estamos ouvindo feedback e melhorando o tempo todo.
Aqui está como começar:
1. **Instale Wasp**
```bash
npm i -g @wasp.sh/wasp-cli
- Instale o plugin Claude Code
# adicione o marketplace Wasp ao Claude
claude plugin marketplace add wasp-lang/claude-plugins

# instale o plugin do marketplace
claude plugin install wasp@wasp-plugins --scope project
- Inicie um novo projeto Wasp
# crie um novo projeto
wasp new

# mude para o diretório raiz do projeto
cd<seu-projeto-wasp>
- Inicie uma sessão Claude Code no diretório do seu projeto Wasp
claude
- Execute o comando init para configurar o plugin
/init-wasp-plugin
A partir daí, você pode pedir ao Claude para “iniciar o servidor de desenvolvimento” e ele o guiará através da configuração da visibilidade fullstack conforme descrevemos acima. Ou peça para implementar um recurso do Wasp e veja-o buscar guias de documentação com versão correspondente para você!

Mais importante ainda, o Wasp como framework avança em território que é ainda mais nativo de IA do que o resto, por causa de seu(s) arquivo(s) de configuração central onde o aplicativo é definido.
Este arquivo de configuração principal é como o blueprint do seu aplicativo. O Wasp pega essas declarações e gerencia o código para esses recursos para você.
Veja este trecho de configuração de autenticação como referência:
app TaskManager {
  wasp: { version: "^0.21.0" },
  title: "Task Manager",
  auth: {
    userEntity: User,
    methods: {
      email: {},
      google: {}
    },
    onAuthFailedRedirectTo: "/login"
  }
}
Assim é uma implementação de autenticação no Wasp. É isso.
Essa configuração de 8 linhas gera o que normalmente exigiria 500-800 linhas de código: componentes, gerenciamento de sessão, hash de senha, fluxos OAuth e esquemas de banco de dados. Claude só precisa saber quais métodos de autenticação você quer.
Claude não precisa se preocupar em escolher que tipo de implementação de autenticação usar ou gerar nenhum código de integração. Pode simplesmente começar a trabalhar na construção de recursos.
Quando Você PRECISA das Coisas Sofisticadas
Passei este artigo inteiro argumentando que você pode ignorar muitos recursos do Claude Code para desenvolvimento de aplicativos fullstack. Mas não quero deixar você com a impressão de que esses recursos são inúteis.
Subagentos personalizados, comandos e skills brilham quando você está fazendo a mesma tarefa repetidamente com critérios consistentes, por exemplo:
- Testes — Um subagentos dedicado a testes que conhece seus padrões de teste, executa suites, analisa falhas e sugere correções.
- Revisão de Código — Um comando ou subagentos de revisão de código que executa testes, corrige bugs e revisa código após cada desenvolvimento.
- Executar Scripts — Skills podem ser úteis se você tiver tarefas determinísticas que executa frequentemente, como um script de implantação ou usar uma ferramenta cli para converter suas imagens de blog para webp. Defina-as em uma Skill e vincule esses scripts a elas, e Claude Code as executará quando julgar apropriado para a tarefa em questão.
Essas são tarefas onde você quer que o mesmo processo seja seguido toda vez e onde um subagentos bem configurado com regras específicas faz sentido.
Na maioria dos casos, recorra à complexidade apenas quando a abordagem mais simples deixar de funcionar.
Agora Construa!
Com esses três ingredientes, acho que a maioria dos desenvolvedores de aplicativos fullstack pode fazer a grande maioria do trabalho sem recorrer a muito mais:
- Um framework opinativo que lida com arquitetura/boilerplate para que Claude não tenha que fazer
- Documentação com versão correspondente para que Claude tenha detalhes de implementação atualizados
- Visibilidade fullstack para que Claude possa ver o que está acontecendo e corrigi-lo por conta própria
Com isso em vigor, o conjunto de ferramentas básico do Claude Code—explorar, planejar, ler, escrever, executar comandos—é suficiente para construir aplicativos fullstack reais e complexos. Os subagentos, hooks, plugins e configurações complexas estão lá se você precisar deles, mas honestamente, na maioria das vezes, você não vai precisar.